
O primeiro documento que o sistema reprovou tinha assinatura digital válida, carimbo de tempo correto e um problema que ninguém tinha visto: a ART anexada era de outro engenheiro, de outra obra, de dois anos antes. O analista havia aprovado o mesmo documento na semana anterior.
Não é falha de atenção. É volume. A área recebia certificados de segurança, olerites, cartões de ponto e programas de gerenciamento de risco de centenas de fornecedores, alguns com mais de mil páginas, e a validação de um dependia do que estava escrito no outro.
O pedido não era validar documento
O pedido que chegou foi "acelerar a conferência de documentação de fornecedor". O diagnóstico mostrou outra coisa: o gargalo não estava na leitura, estava na validação cruzada — conferir se o nome do responsável técnico no certificado bate com o da ART, se a data de emissão cobre o período do contrato, se o CNPJ é o mesmo dos três anexos.
Quem fazia isso tinha o critério na cabeça. Não estava no procedimento, não estava no sistema, e mudava de fornecedor para fornecedor. Extrair esse critério e escrevê-lo com rigor levou mais tempo que construir o software.
Por que o pipeline é próprio
Mil páginas não entram em uma janela de contexto de forma útil. Testamos duas abordagens antes da que ficou: mandar o documento inteiro e pedir o veredito, e depois quebrar em páginas independentes. A primeira alucinava datas; a segunda perdia exatamente a informação que estava em duas páginas ao mesmo tempo.
O pipeline que ficou tem quatro etapas:
- Classificação do documento por tipo, antes de qualquer leitura de conteúdo — certificado, olerite, cartão de ponto e ART seguem regras diferentes.
- Corte em blocos com sobreposição, para que nenhuma regra caia na fronteira entre dois pedaços.
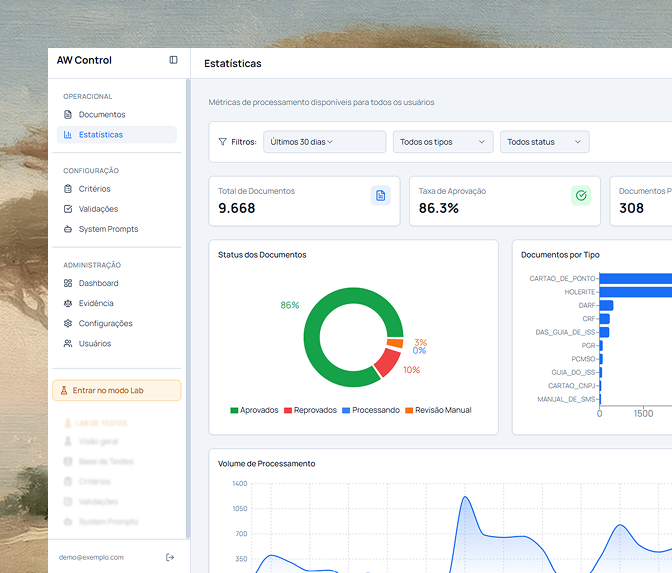
- Extração campo a campo, com o número da página registrado junto de cada valor extraído.
- Validação cruzada entre os anexos do mesmo fornecedor, e só então o veredito.
O registro da página em cada campo é o que permite a única coisa que o analista pediu explicitamente: clicar no motivo da reprovação e cair na folha onde ela está.
Onde a IA errou primeiro
Assinatura digital foi o erro mais caro do começo. O sistema tratava a presença do certificado como prova de validade, e havia documento com assinatura expirada no momento da emissão. A correção não foi de modelo: passamos a validar a assinatura contra a API do Gov.br e a comparar a imagem da assinatura manuscrita com as anteriores do mesmo signatário.
O segundo erro foi de critério, não de leitura. O sistema reprovava olerite sem o campo de insalubridade — porque o especialista reprovava. Ao revisar caso a caso, o próprio especialista concluiu que a regra dele estava errada para dois cargos. Esses casos saíram da base.
- Quando a IA errou, ajustamos o critério escrito e rodamos a base inteira de novo.
- Quando o humano errou, o caso saiu do gabarito — com registro de quem decidiu e por quê.
Como medimos os 97%
Antes da primeira linha de código, montamos uma base de casos reais com a resposta que o especialista daria. Cada versão do sistema roda contra essa base e cada divergência é analisada uma por uma. Assertividade aqui não é uma nota de prova: é a taxa em que o sistema concorda com o gabarito humano nos casos que já sabemos julgar.
Números
- R$ 40.000 /MÊS
- economizados em um único tipo de documento
- 97%
- de assertividade medida contra gabarito humano
- 1.240
- páginas no maior documento processado até aqui
O laboratório de teste onde essa medição roda ficou dentro do sistema do cliente. Quem sobe caso novo, compara versões e decide o que vai para produção é a equipe deles — o número acima é auditável por quem paga por ele.
A leitura comercial desse projeto, com o contexto do cliente e o resultado medido, está no estudo de impacto da Athie Wohnrath.


